Большинство «ИИ-компаний» — это промпт, ключ к чужому API и красивая презентация. Мы устроены иначе. За пять с половиной месяцев мы построили полный собственный стек: движок инференса, который на равных соревнуется с llama.cpp и часто его обгоняет; агентный рантайм с постоянной памятью, планировщиком и вытеснением задач; систему измерений, которая каждую ночь решает, стал ли агент лучше; и цикл дообучения, в котором агент меняет собственные веса только после статистического доказательства. Всё — на Rust, всё — в продакшене 24/7 на обычных потребительских GPU. Ниже — не обещания, а цифры из наших бенчмарков с указанием, где они лежат.
Мы не пользователи чужого ИИ. Мы делаем каждый слой сами — от ядра, которое пишет в GPU, до агента, который ночью дообучает собственные веса и утром доказывает, что стал лучше.Строк Rust: agi-core, llamars, agi-web-ui, uide, codex-substrate — с ~1700 тестами.
Быстрее llama.cpp: GPU-префилл Qwen3.5-35B на RX 6900 XT (Vulkan), на всех глубинах контекста.
Сжатие KV-кэша (MLA): 30 КиБ на токен вместо ~270. Огромный контекст на слабом железе.
Вместо 106 с — ответ на сообщение, прерывающее бегущую задачу: чекпоинт и переиспользование KV.
Свой движок,а не обёртка над llama.cpp.
llamars — чистый Rust, ~150K строк, Vulkan и Metal без единой строки C.
Путь был честным: сначала биндинги к llama.cpp, потом рантайм на них — и упор в потолок. Чужой движок нельзя научить сохранять состояние диалога на диск, делить GPU между двумя дорожками генерации или сообщать оркестратору честную ёмкость контекста. Так появился llamars — собственный движок инференса моделей GGUF.
Внутри — вещи, которые обычно есть только у авторов фреймворков. На Metal весь граф модели живёт на GPU: один command buffer на токен, слитые norm+matvec, упакованный QKV, flash-decoding с дозаписью KV, f16-активации end-to-end (ggml до сих пор держит f32). На Vulkan — цепной GEMM для префилла, int8-декод, cooperative-matrix ядра f16/fp8, флеш-декод с общим GQA, KV-арены в q4_0. И MLA-кэш для моделей семейства DeepSeek: 30 КиБ на токен вместо 270.
| Модель · железо | llamars | llama.cpp | Δ |
|---|---|---|---|
| Qwen3-8B Q4_K_M · M1 Max, Metal · pp512 / tg128 | 524 / 47.8 | 473 / 45.0 | +10.8% / +6.3% |
| TinyLlama 1.1B · M1 Max, Metal · pp512 / tg128 | 3626 / 239 | 3217 / 232 | +12.7% / +3.2% |
| Qwen3.5-35B-A3B · RX 6900 XT, Vulkan · GPU pp512 | 3135 | 1762 | +78% |
| Qwen2.5-Omni-3B · RX 6900 XT · audio encode, 2.5 с | 150 мс | 364 мс | ×2.4 |
| Qwen3-Embedding-0.6B · embed, 11 токенов | 200 мс | 540–768 мс | ×2.7 |
Движок мультимодальный: 32-слойный энкодер Whisper или ViT исполняется одним command buffer, TTS CosyVoice3 (языковая модель, flow-matching и вокодер) переписан на Rust целиком, диффузия SDXL/Flux/Wan рисует бит-идентичные картинки между перезапусками. И — редкость для инференс-движков — нативное дообучение LoRA прямо на квантованных весах: 27B-модель, контекст 4096, 52 секунды на шаг, на одной потребительской карте.
Мы не прячем, с чего начинали. Первая версия движка получила внутренний документ с названием *Brutal Reality Check*: красивая архитектура бэкендов, ноль токенов в секунду, загружается 44 тензора из 201. Его переписали снизу вверх — от одного работающего матричного умножения до графа на GPU — и с тех пор каждое ядро появляется только вместе с бенчмарком против llama.cpp на том же железе.
Память,которая переживает перезапуск.
UIDE — своё хранилище: RocksDB, собственный HNSW, подписанный журнал операций.
Агент без памяти — чат-бот. Мы выделили память в отдельный движок UIDE: персистентное KV поверх RocksDB, эмбеддинги, собственный компактный HNSW-индекс без зависимостей (recall@10 ≥ 0.9 против полного перебора), снапшоты индекса с дельта-сверкой вместо пересборки, и подписанный Ed25519 журнал операций — задел под федерацию памяти между инстансами. Инференс в UIDE инжектируется через трейт: хранилище ничего не знает о том, откуда берутся векторы.
Goal Graph
Постоянный DAG задач поверх памяти: дайджесты узлов, бюджеты токенов на шаг, урок из ошибки доступен уже на следующем шаге того же запуска.
Три уровня для KV
VRAM → RAM → NVMe с измеренной ценой восстановления, без констант в коде. Диалог на 83 000 токенов с картинкой: ход за 10.5 с вместо ≈56 с полного пересчёта.
Recall под контролем
Бенчмарк памяти: recall@5 = 0.963, MRR = 0.935, медиана 966 мс. Балансировка по классам, чтобы редкие воспоминания не тонули.
Рантайм,в котором всё — шаг.
AGI Core: ~170K строк, ~1200 тестов, 1227 коммитов за 5.5 месяцев.
AGI Core — минимальное ядро автономного агента: движок потоков, реестр инструментов, память, шина событий, маршрутизатор инференса и транспорт. Всё остальное — плагины и JSON-описания процессов, которые можно менять в рантайме. Роутер держит четыре бэкенда одновременно: локальные GGUF через llamars, OpenAI-совместимые API, Anthropic и удалённый agi-core — и выбирает по задаче.
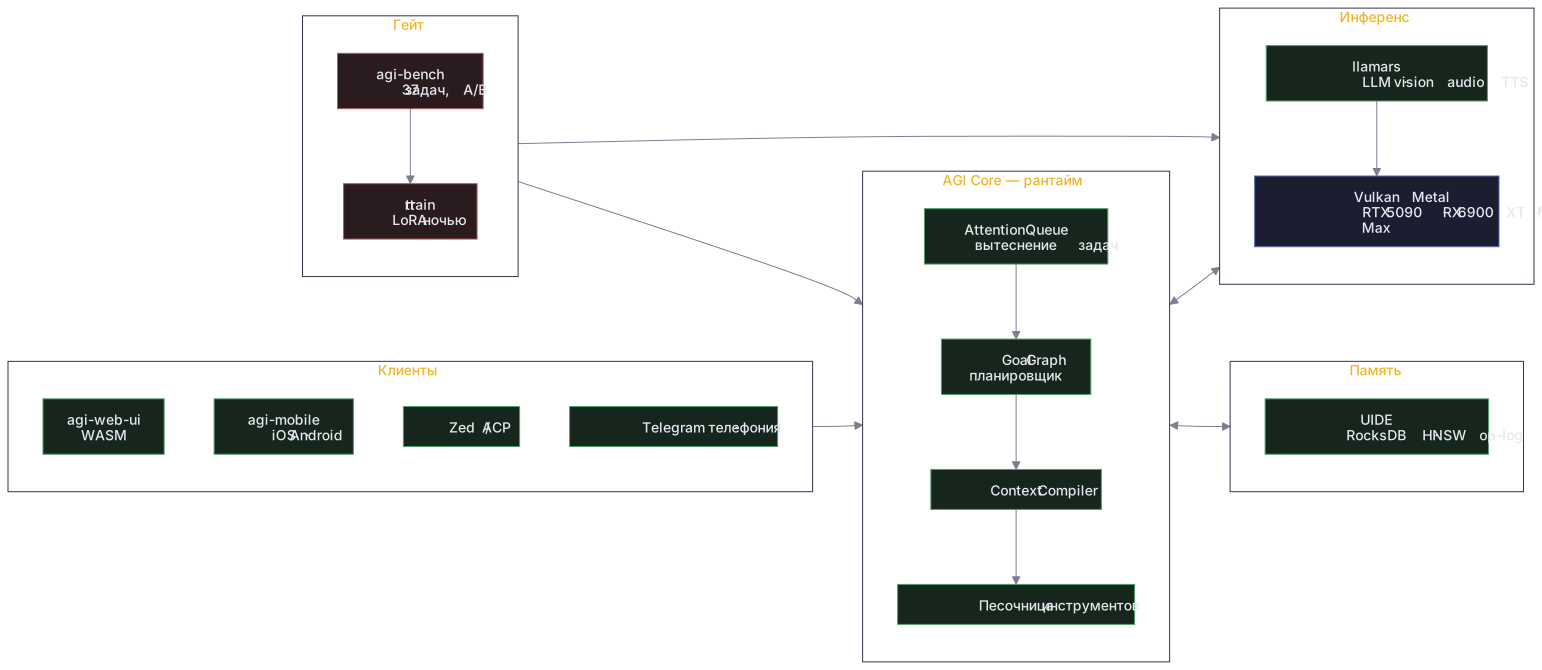
Несколько решений, которых нет в популярных фреймворках агентов:
- AttentionQueue. Сообщение пользователя вытесняет бегущую задачу на безопасной точке: чекпоинт, переиспользование KV-префикса, ответ — и возврат к задаче. Измерено: 12 секунд вместо 106.
- Единый язык шагов. Каждый шаг — узел графа с типом эффекта (чистый / мир / суждение). Чистые участки сливаются, «мировые» пишутся в журнал и воспроизводимы, вебхуки — тоже узлы графа, без кода на каждый канал.
- Client I/O. Мозг на сервере, руки — у пользователя: файлы, шелл и терминал исполняются в его рабочем окружении через обратный RPC (Zed через ACP, браузер, демон).
- App Modules. Агент собирает мини-приложения, где интерфейс — данные, а не код; они запускаются на веб- и мобильных клиентах без пересборки.
- Plugin ABI. Нативные
.so/.dylibс C-символами, горячая загрузка — инструмент можно дописать на любом языке.
Экономию тоже измеряем. Один из бенчмарков агентного цикла: до оптимизации — 5 задач из 6 и 217 904 токена, после — 6 из 6 и 88 548 токенов, минус 59 %. Это не «модель стала умнее», это компилятор контекста перестал носить в промпт лишнее.
Агент, которыйучится ночью — и обязан это доказать.
agi-bench: 37 задач, 7 категорий, доверительные интервалы Уилсона, каждую ночь.
Самоулучшение без измерения — самообман. Поэтому бенчмарк живёт отдельно от агента, в каталоге, куда у процесса агента нет прав; задачи параметризованы сидом, чтобы их нельзя было заучить; часть набора отложена (held-out). Каждую ночь по таймеру: прогон, сравнение с базой, бутстрэп разницы.
00:30 UTC — собрать корпус из «полётного регистратора» агента за сутки: ~6.6 млн токенов за двое суток работы.
Остановить ядро, освободить GPU.
Дообучить LoRA на собственной квантовке: 27B-модель, ~120 шагов, 24 секунды на шаг.
Прогнать бенчмарк с новым адаптером (B), затем со старым (A) — 30 задач × 3 попытки.
Сравнить: интервал Уилсона, бутстрэп разницы. Вердикт: promote / hold / reject.
Поднять ядро с победителем. Ничего не менять, если доказательства нет.
Первая полная ночь закончилась вердиктом reject — и оказалось, что бенчмарк измерил не качество, а память: слияние адаптера при загрузке держало 14 ГиБ. Починили формат деплоя, следующая ночь дала hold: B 89/90 против A 88/90 — разница в шуме. Нет доказательств — нет изменения весов. Мы считаем это самым важным свойством системы, а не её слабостью.
Код,который можно проверить формально.
codex-substrate: контент-адресуемый граф программ с ядром доказательств.
Следующий слой уже в прототипе: codex-substrate — граф кода, где каждая функция нормализована, захеширована BLAKE3 и подписана Ed25519, с выводом типов Хиндли–Милнера, зависимо-типизированным ядром доказательств, импортом из Lean 4 и компиляцией в WebAssembly. А в самом AGI Core живёт верифицированный декомпилятор: башня модулей от единственного атома nand восстановила libm целиком — 38 из 38 функций с точностью 10⁻¹² на 20 000 проб каждая, бинарь на 31 % меньше оригинала. Это то, что позволит агенту менять собственный код, доказывая корректность, а не надеясь на неё.
Что из этогонужно вашему бизнесу.
Мы советуем не по слайдам: каждый совет за последние полгода проверен на нашем железе.
Всё описанное выше мы делали для себя — и именно поэтому знаем, где в ИИ-проектах теряются деньги. Чаще всего в трёх местах: переплата за чужие API там, где хватило бы 35B-модели на одной карте; агенты без памяти и без измерений, которые «вроде работают»; и данные, которые уезжают в чужое облако, потому что «иначе нельзя». Можно иначе.
Аудит и архитектура
Разбираем ваш ИИ-контур: модели, стоимость токена, латентность, память, безопасность инструментов. Отдаём план с цифрами — что оставить в API, что перенести к себе, что переписать.
Инференс у вас
Разворачиваем модели on-premise на потребительских GPU или в вашем облаке: квантование, KV-кэш под ваш контекст, батчинг. Меряем против вашего текущего API — в токенах в секунду и в деньгах.
Агенты и обучение
Проектируем агентов с памятью, планировщиком и гейтом качества; ставим ночной цикл дообучения на ваших данных. Или отдаём готовые роли — юрист, бухгалтер, рекрутер, ассистент, звонки, чаты.
Формат — от однодневного аудита до внедрения под ключ с нашим рантаймом внутри вашего периметра. Напишите на hello@0xd.to или через форму на сайте: опишите задачу и что уже стоит — вернёмся с планом и оценкой. Про то, почему агентам нужна песочница, — в отдельной статье.
Ценность консультанта — в том, что он уже наступил на грабли, которые вы ещё не купили. У нас за спиной свой движок, свой рантайм и свой бенчмарк — и папка post-mortem'ов по каждому.Продукты из статьи
Консультация по ИИ
Аудит стека, инференс у вас, агенты с памятью и ночным обучением — от людей, которые написали всё это сами.
 Зачем агенту безопасности нужна песочница
Агент, который «просто запускает инструменты» на разборе, — второй атакующий, пока у каждого вызова нет гранта. AGI Core изолирует инструменты; Forge держит список скиллов в UIDE.
 Умный дом под ключ на собственной ОС: 0xd-os и 0xd-ui
Мы строим умные дома под ключ на компонентах собственной разработки. В основе — ОС 0xd-os, которая одинаково работает на флагманском планшете и в устройстве с 512 КБ памяти.
 Чей это компьютер? Ваш, или…
Мы написали ОС с нуля на Rust и запустили её на Samsung Galaxy Tab S6. В устройстве живёт по меньшей мере восемь исполняющихся сущностей — семь не наши, и почти каждая может нас убить. Карта жильцов — вводная статья серии о том, кому принадлежит современный SoC.